양자 오류정정에 대해 들어보셨나요? 오늘은 양자 컴퓨터와 관련된 진로 트렌드를 알아보겠습니다.
“양자컴퓨터가 임계점을 넘었다.”
몇 해 전부터 이 제목이 주기적으로 등장합니다. 그런데 무엇이 넘어갔다는 건지, 그래서 지금 어디쯤인지는 기사에 잘 안 나옵니다.
숫자로 보면 꽤 또렷합니다. 그리고 이 소재는 고등학생이 직접 계산해 볼 수 있는 몇 안 되는 최신 물리 주제이기도 합니다.
큐빗 하나로는 아무것도 못 합니다
양자컴퓨터의 계산 단위는 큐빗입니다. 그런데 큐빗은 아주 잘 망가집니다. 주변 온도, 전자기파, 진동 같은 것에 상태가 흐트러져요.
그래서 나온 방법이 여러 개의 물리 큐빗을 묶어 하나의 논리 큐빗을 만드는 것입니다. 여러 개가 서로를 감시해 오류를 잡아내는 구조죠. 이게 양자 오류정정입니다.
양자 오류정정이 보통의 오류정정과 다른 점이 하나 있습니다. 일반 컴퓨터에서는 값을 복사해 두고 다수결로 정하면 되는데, 양자 상태는 복사가 원리적으로 불가능합니다. 그래서 상태를 직접 보지 않고 오류가 났다는 사실만 간접적으로 알아내는 방식을 씁니다. 이 제약 때문에 물리 큐빗이 많이 필요해집니다.
묶는 크기를 부호 거리라고 부릅니다. 거리가 클수록 많이 묶고, 많이 묶을수록 튼튼해집니다.
거리를 늘리면 오류가 줄어듭니다
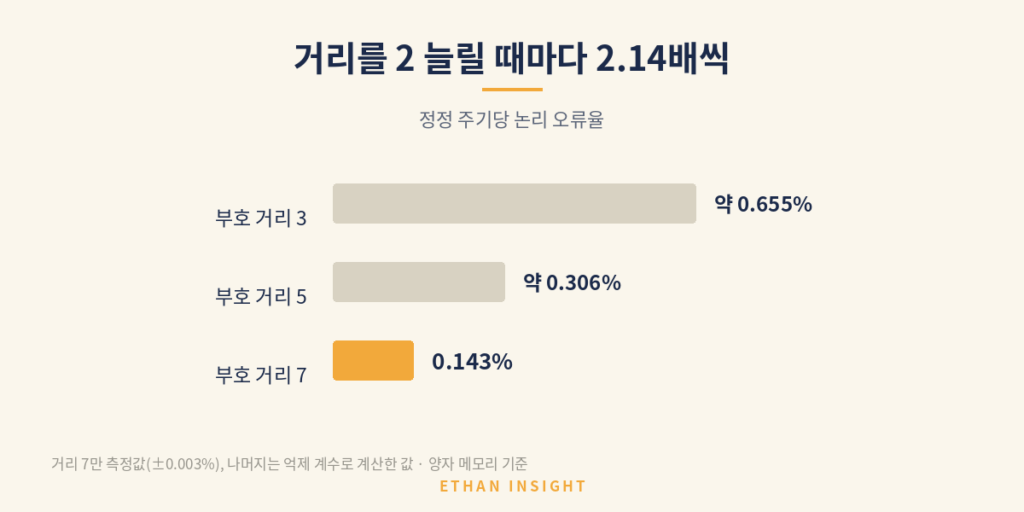
핵심 결과는 이렇습니다. 부호 거리를 2 늘릴 때마다 논리 오류율이 2.14배씩 줄어듭니다. 오차는 ±0.02예요. 이 줄어드는 비율을 오류 억제 계수라고 합니다.
| 부호 거리 | 정정 주기당 논리 오류율 |
|---|---|
| 거리 3 | 약 0.655% (계산값) |
| 거리 5 | 약 0.306% (계산값) |
| 거리 7 | 0.143% ± 0.003% |
거리 7에서 실제로 측정된 값이 0.143%이고, 앞의 두 값은 억제 계수 2.14를 거꾸로 적용해 제가 계산한 값입니다.
계산은 곱셈 두 번입니다. 0.143에 2.14를 곱하면 약 0.306, 거기에 한 번 더 곱하면 약 0.655가 나옵니다. 거리를 2씩 줄일 때마다 오류율이 2.14배씩 늘어난다고 보고 거슬러 올라간 거예요. 계산기로 30초면 직접 확인할 수 있고, 이렇게 확인해 본 숫자는 기사에서 읽은 숫자와 무게가 다릅니다.
여기가 이 결과의 의미입니다. 예전에는 큐빗을 더 묶을수록 오히려 오류가 늘었습니다. 감시할 큐빗 자체가 오류를 만들었으니까요. 그런데 이제 묶을수록 나아지는 구간에 들어섰습니다. 넘었다는 임계점이 이겁니다.
실제로 거리 7 논리 큐빗은 가장 좋은 물리 큐빗 하나보다 2.4 ± 0.3배 오래 상태를 유지했습니다. 묶은 게 낱개보다 나아진 첫 사례예요.
값은 얼마였나
대가가 있습니다. 거리 7 논리 큐빗 하나를 만드는 데 물리 큐빗 101개가 들어갔습니다.
논리 큐빗 하나, 그러니까 계산 단위 하나를 얻는 데 백 개를 쓴 겁니다. 여기에 조건이 하나 더 붙습니다. 이 결과는 양자 메모리 기준입니다. 상태를 유지하는 실험이지 연산을 돌린 게 아니에요. 정보를 얼마나 오래 안 잃는지를 본 것이고, 실용 계산 단계 아님을 분명히 해야 합니다.
속도 쪽 숫자도 있습니다. 정정 주기는 1.1마이크로초인데 실시간 해독에 63마이크로초가 걸렸습니다. 오류를 판단하는 계산이 오류가 쌓이는 속도를 못 따라가는 상태입니다.
아직 1,000배가 남았습니다
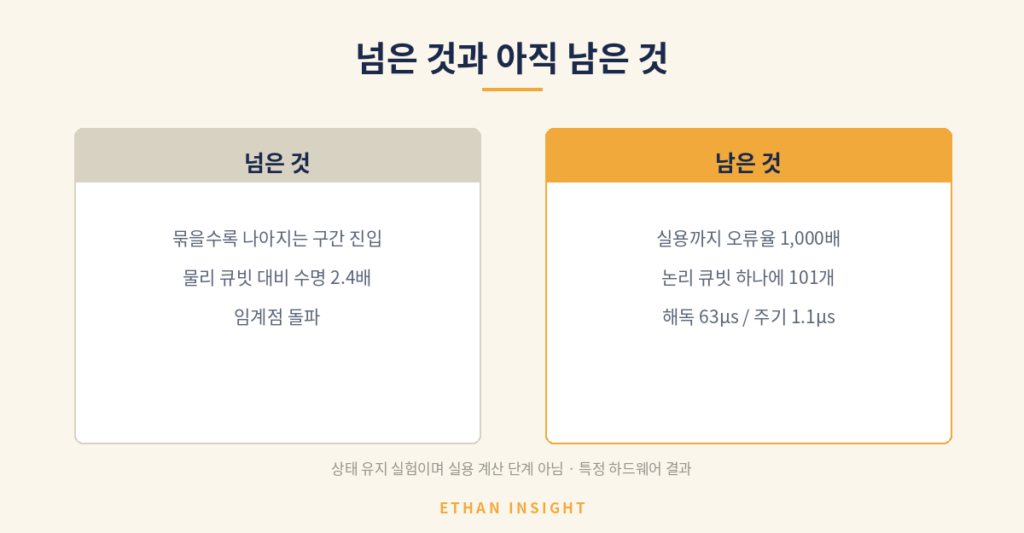
실용적인 계산을 하려면 논리 오류율이 100만 분의 1, 그러니까 0.0001% 수준이어야 한다고 봅니다. 현재는 0.143%예요.
1,000배 이상 차이가 납니다.
억제 계수 2.14로 이 간격을 메우려면 거리를 2씩 약 열 번 올려야 합니다. 거리 27쯤 되고, 물리 큐빗은 논리 큐빗 하나당 1,457개 정도가 필요해집니다. 계산기로 직접 해볼 수 있는 나눗셈과 거듭제곱입니다. 어디까지 계산해도 되는지는 수치 탐구 기준에 정리해 두었습니다.
여기에 더 까다로운 문제가 하나 있습니다. 약 30억 주기, 시간으로는 한 시간쯤에 한 번씩 여러 큐빗이 동시에 무너지는 오류가 관측됐습니다. 이건 거리를 늘려도 줄지 않습니다. 오류정정의 전제가 “오류는 서로 독립적으로 생긴다”인데, 동시에 생기는 오류는 그 전제 밖이거든요. 지수적으로 줄어드는 곡선에도 바닥이 있다는 뜻입니다.
물리·컴퓨터 지망생이 볼 지점
양자 오류정정이 탐구 소재로 좋은 이유는 한계가 감춰져 있지 않다는 점입니다. 연구진이 스스로 남은 거리를 숫자로 밝혀 놨습니다.
듣는 과목에 따라 이렇게 갈라집니다.
- 수학 쪽 — 2.14배씩 줄어드는 구조는 어떤 함수인가, 몇 단계면 목표에 닿나
- 물리 쪽 — 여러 큐빗이 동시에 무너지는 원인은 무엇으로 추정되나
- 컴퓨터 쪽 — 해독 63마이크로초를 1.1마이크로초 아래로 줄이려면 무엇이 필요한가
첫 번째도 만만치 않게 좋습니다. 같은 비율로 줄어든다는 건 지수함수 이야기라, 수학 시간에 배운 내용이 최신 실험의 핵심 숫자를 읽는 데 그대로 쓰이는 경험을 하게 됩니다.
세 번째가 특히 좋습니다. 양자 이야기 같지만 실제로는 실시간 알고리즘 문제라서요. 주제를 좁히는 순서는 탐구주제 3단계에 있습니다.
출발선에 선 것입니다
이 숫자들은 특정 하드웨어에서 나온 결과입니다. 다른 방식의 큐빗에서는 다른 값이 나옵니다. “양자컴퓨터가 이만큼 왔다”가 아니라 “이 방식이 이 조건에서 이만큼 왔다”가 정확한 문장이에요.
그리고 임계점을 넘었다는 건 출발선에 섰다는 뜻이지 도착했다는 뜻이 아닙니다. 남은 1,000배를 같이 말하지 않는 기사는 절반만 전한 겁니다.
같은 구조의 함정을 AI 신물질 편에서도 다뤘습니다. 큰 숫자가 나오면 조건을 먼저 찾는 습관, 그것 하나면 충분합니다.
